雾月
雾月
这家伙很懒,什么也没写!

注册于 6年前

回答
270
文章
2
关注者
26

可以保存切点和向量终点的坐标,然后利用 perpendicular 坐标系统即可画出。
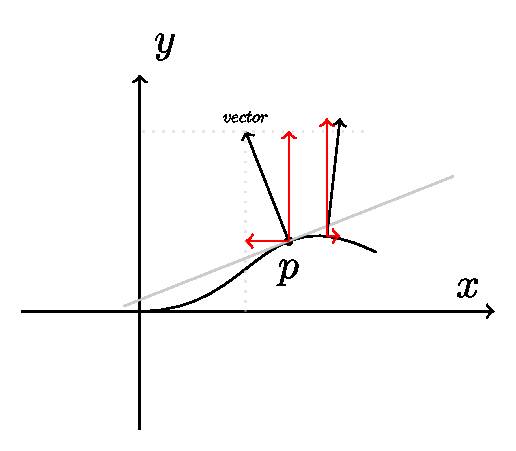
ans-145-tikz.jpeg

\documentclass[tikz,border=5pt]{standalone}
\usetikzlibrary{decorations.markings}

\makeatletter 
\def\my@tangentparse#1{\in@{ at}{#1}%
  \ifin@\my@tangentparse@#1\@nil\else\my@tangentparse@ last at#1\@nil\fi}
\def\my@tangentparse@#1 at#2\@nil{\pgfkeysalso{postaction=decorate,
  decoration = {    % 对path进行装饰(decorate)
    markings,    % 启用marking
    mark = at position #2    % 在指定位置#1添加marking
      with{    % marking的具体内容
        % 定义(0, 0)为tangent point xxx,即切点
        \coordinate (tangent point #1) at (0, 0);
        % 定义(1, 0)为tangent unit vector xxx,即单位切向量
        \coordinate (tangent unit vector #1) at (1, 0);
        % 定义(0, 1)为tangent orthogonal unit vector xxx,即单位法向量
        \coordinate (tangent orthogonal unit vector #1) at (0, 1);
      }
  },
}}
\tikzset{
  tangent/.code = \my@tangentparse{#1},
  use tangent/.style = {    % 定义use tangent样式,参数#1是切点的序号
    shift = (tangent point #1),     % 以tangent point-xxx为原点
    x = (tangent unit vector #1),    % 以tangent unit vector-xxx为x轴单位向量
    y = (tangent orthogonal unit vector #1)% 以tangent orthogonal unit vector-xxx为y轴单位向量
  },
  use tangent/.default = last,
}
\makeatother
\begin{document}
\begin{tikzpicture}
\draw[->] (-1,0) -- (3,0) node[anchor=south east]{$x$};
\draw[->] (0,-1) -- (0,2) node[anchor=south west]{$y$};
\draw[tangent=A at 0.65,tangent=B at 0.8] (0, 0) .. controls (1, 0) and (1, 1) .. (2, 0.5);
\fill[use tangent=A] circle(1pt) node[below=1] {$p$};
\draw[black!20,use tangent=A] (-1.5, 0) -- (1.5, 0);%切线
\draw[->, use tangent=A] (0, 0) -- (0, 1) coordinate(L) node[scale=0.4,above=2] {$vector$}; %法线

\draw[dotted,black!10, shorten <=-1cm] (L) -- (0,0 |- L); %辅助线
\draw[dotted,black!10] (L) -- (0,0 -| L); %辅助线

\draw[red,->] (tangent point A) -- (L |- tangent point A);
\draw[red,->] (tangent point A) -- (L -| tangent point A);

\draw[->, use tangent=B] (0, 0) -- (0, 1) coordinate(L);
\draw[red,->] (tangent point B) -- (L |- tangent point B);
\draw[red,->] (tangent point B) -- (L -| tangent point B);

\end{tikzpicture}
\end{document}
在导言区加上 \usefonttheme{professionalfonts}。可以放在 \usepackage{mtpro2} 前一行。

如果没有递增计数器,\ref 显示为空,hyperref 不会为空的文本创建超链接。
只能使用 \hyperref[<label>]{<text>} 或 \pageref。

也可以在写入 \label 时就指定需要显示的文字:

\documentclass{article}

\usepackage{tcolorbox}
\usepackage{hyperref}


\tcbuselibrary{skins,minted}

%% 重定义minted环境前的行号样式
\renewcommand{\theFancyVerbLine}
{%
  \ttfamily\textcolor[rgb]{0.5,0.5,1.0}
  {%
    \footnotesize\arabic{FancyVerbLine}
  }
}

\makeatletter
\protected\def\setnextlabeltext#1{\AddToHookNext{label}{\protected@edef\@currentlabel{#1}%
  \edef\@currentlabel{\detokenize\expandafter{\@currentlabel}}}}
\makeatother
\newcounter{myexample}
\NewTCBListing{myjava}{O{} O{}}{%
    listing engine  = minted,
    minted style    = colorful,
    minted language = java,
    %minted label =#1
    minted options={%
        fontsize = \small,
        breaklines,
        autogobble,
        linenos,
        numbersep = -1.5mm,
        %numbersep   = 3pt,
        keywordcase = lower, % 关键字小写, upper为大写, capitalize为首字母大写, 默认为lower
        mathescape  = true,  % 在注释中可以书写并渲染数学公式
        showspaces  = false,
        tabsize     = 4,
        texcomments = false,
        %framerule   = 1pt,
        %breaklines  = true,
        fontfamily  = tt,
    },
    %colback  = blue!5!white,
    %colframe = blue!75!black,
    colback  = white,
    colframe = black,
    colbacktitle=white,
    coltitle=black,
    listing only,
    left = 5mm,
    enhanced,
    overlay = {\begin{tcbclipinterior}\fill[red!20!blue!20!white] (frame.south west)
    rectangle ([xshift = 5mm]frame.north west);\end{tcbclipinterior}},
    attach boxed title to top center = {yshift =-3mm},
    center title,
    %IfValueTF = {#1}{title=#1}{step=myexample, title=code:\themyexample},
    IfEmptyTF = {#1}{% 第一个没有值
      step=myexample, title=code:\themyexample, 
      IfEmptyTF={#2}{label=code:\themyexample}{label={#2}}
    }{% 第一个有值
      title={#1}, IfEmptyTF={#2}{}{phantom=\setnextlabeltext{#1},phantomlabel={#2}}
    },
    fonttitle = \ttfamily\large,
    boxrule=0.75pt,
    boxed title style={
        boxrule=0pt,
        colframe=white,
        size = fbox,
    },
    %frame hidden
    %boxed title style={arc=0pt,outer arc=0pt,boxrule=0pt}, 
}

\begin{document}

\begin{myjava}[test][aaa]
    public class HelloWorld {
        // A `Hello World' in Java
        public static void main(String[] args) {
        System.out.println("Hello World!");
    }
    }
\end{myjava}

\begin{myjava}
    public class HelloWorld {
        // A `Hello World' in Java
        public static void main(String[] args) {
        System.out.println("Hello World!");
    }
    }
\end{myjava}

a\hyperref[aaa]{text}.\pageref{aaa}.\ref{aaa}.\ref{code:1}.

\end{document}

这个 \setnextlabeltext 也可以在递增计数器之后,\label 之前使用。

microtype 的多数功能只是对 primitive 的封装,XeTeX 缺少对应的 primitive,很多功能没法实现。

某些功能有替代办法,比如 \textls 可以通过设置 fontspec 的选项 WordSpace、LetterSpace 为合适的值来替代。

\documentclass{..}
\usepackage{morewrites}
...

或

\RequirePackage{morewrites}
\documentclass{..}

morewrites 要放在很前面才能有效。

这是右边页码宽度增加了,但是 logo 和页码的距离不变,所以 logo 往左移了一点。
如果使用 fancyhdr,titleps等,应该对左、中、右的页眉分别设置,而不是设置一个固定长度。

封面和目录应当设置 nomarginpar。
\fancyhfoffset 只有 fancyhdr 定义的 pagestyle 才有用,必须用 \fancypagestyle 重新定义 plain 样式。
每次修改 geometry 都要重新设置 \fancyheadoffset 和 \fancyfootoffset,否则页眉页脚的位置可能不对。

mod.tex

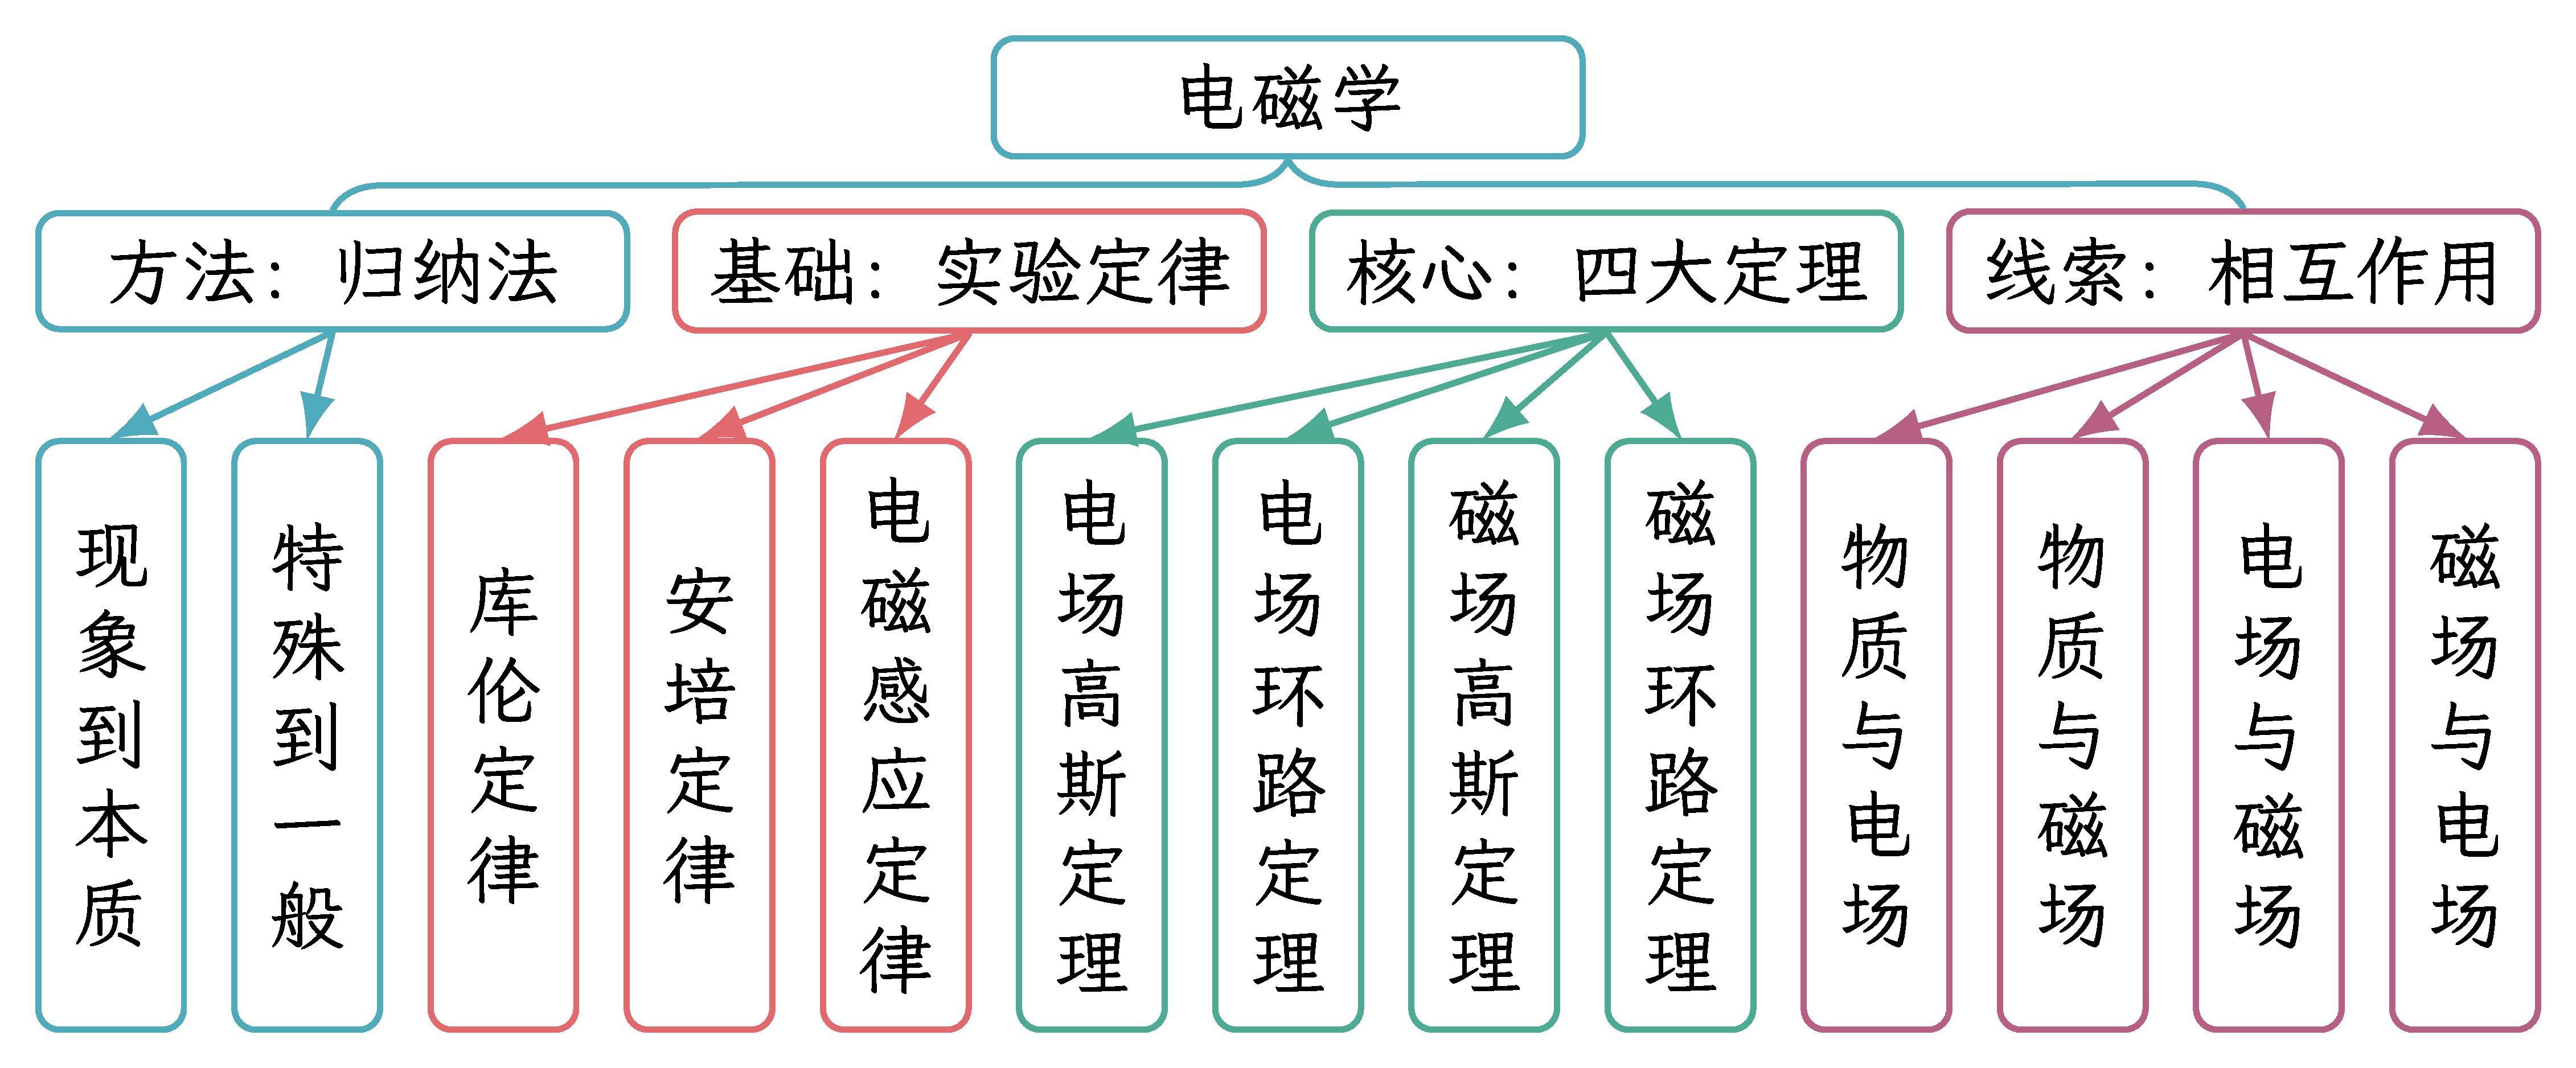
使用 positioning 库可以以相对位置排布 node,容易排出第二行。之后使用使用第二行的宽度与第三行单个 node 的宽度可以计算出第三行 node 之间的间距,然后用和第二行一样的方法即可。

ans-133-tikz.jpg

字体为 霞鹜文楷:https://github.com/lxgw/LxgwWenKai 。

\documentclass[tikz,border=5pt]{standalone}
\usetikzlibrary{positioning,decorations.pathreplacing,shapes.misc,arrows.meta}
\usepackage{ctex}
\setCJKmainfont{LXGW WenKai} % https://github.com/lxgw/LxgwWenKai
\begin{document}

\definecolor{col1}{HTML}{4faabc}
\definecolor{col2}{HTML}{e26a6f}
\definecolor{col3}{HTML}{4eab93}
\definecolor{col4}{HTML}{b85f84}

\makeatletter
\newcommand\tvtext[2]{\pgfmathparse{#1}\vbox to\pgfmathresult\p@{\vss\hsize=1em#2\vss}}
\newcommand\getsepoffixedwidth[5]{%
  \begingroup
  \pgf@process{\path#1;}\pgf@xa=\pgf@x
  \pgf@process{\path#2;}\pgf@xb=\pgf@x
  \pgf@process{\path#3;}\pgf@xc=\pgf@x
  \pgfmathparse{(\pgf@xb-\pgf@xa-(#4)*2*(\pgf@xc-\pgf@xa))/(#4-1)}%
  \edef\x{\endgroup\def\noexpand#5{\pgfmathresult pt}}\x}
\makeatother

\begin{tikzpicture}[
  l0style/.style={draw=#1,thick,rectangle,rounded corners=3pt},
  l1style/.style={l0style=#1,text width=76pt,align=center},
  l2style/.style={l0style=#1,text width=76pt,align=center},
  l3style/.style={l0style=#1,text height=76pt,inner xsep=5pt},
  llstyle/.style={draw=#1,thick,-Latex},
]
% level 1
\node(l1) [l1style=col1] at (0,0) {电磁学};
% level 2 node 2
\node(l2-2) [below left=7pt and 3pt of l1.south, l2style=col2] {基础:实验定律};
\node(l2-1) [left=6pt of l2-2.west, l2style=col1] {方法:归纳法};
\node(l2-3) [right=6pt of l2-2.east, l2style=col3] {核心:四大定理};
\node(l2-4) [right=6pt of l2-3.east, l2style=col4] {线索:相互作用};

\def\TV#1{\tvtext{76pt}{\linespread{1}\selectfont \noindent#1}}
\node(l3-1) [below right=15pt and 0pt of l2-1.south west, l3style=col1]{\TV{现象到本质}};
\getsepoffixedwidth{(l2-1.west)}{(l2-4.east)}{(l3-1.center)}{13}{\sep}
\node(l3-2) [right=\sep of l3-1, l3style=col1]{\TV{特殊到一般}};
\node(l3-3) [right=\sep of l3-2, l3style=col2]{\TV{库伦定律}};
\node(l3-4) [right=\sep of l3-3, l3style=col2]{\TV{安培定律}};
\node(l3-5) [right=\sep of l3-4, l3style=col2]{\TV{电磁感应定律}};
\node(l3-6) [right=\sep of l3-5, l3style=col3]{\TV{电场高斯定理}};
\node(l3-7) [right=\sep of l3-6, l3style=col3]{\TV{电场环路定理}};
\node(l3-8) [right=\sep of l3-7, l3style=col3]{\TV{磁场高斯定理}};
\node(l3-9) [right=\sep of l3-8, l3style=col3]{\TV{磁场环路定理}};
\node(l3-10) [right=\sep of l3-9, l3style=col4]{\TV{物质与电场}};
\node(l3-11) [right=\sep of l3-10, l3style=col4]{\TV{物质与磁场}};
\node(l3-12) [right=\sep of l3-11, l3style=col4]{\TV{电场与磁场}};
\node(l3-13) [right=\sep of l3-12, l3style=col4]{\TV{磁场与电场}};

\path[decorate,decoration={brace,amplitude=7pt},draw=col1,thick] (l2-1.north) -- (l2-4.north);
\begin{scope}[shorten >=-.4pt]
\foreach \i in {1,2} \path[llstyle=col1](l2-1.south)--(l3-\i.north);
\foreach \i in {3,...,5} \path[llstyle=col2](l2-2.south)--(l3-\i.north);
\foreach \i in {6,...,9} \path[llstyle=col3](l2-3.south)--(l3-\i.north);
\foreach \i in {10,...,13} \path[llstyle=col4](l2-4.south)--(l3-\i.north);
\end{scope}
\end{tikzpicture}

\end{document}

\foo 1 2 {} 得到的是 *1, 2 *,而不是 *1,2*。

TeX 宏的参数有两种,一种是没有分隔符的参数(或定界符,undelimited parameter),另一种是有分隔符的参数(delimited parameter)。参数的分隔符就是两个参数之间的记号,是标记参数结束的一些符号。

TeX 在开始读取 undelimited parameter 时,会忽略空格,之后如果发现第一个记号是 begin-group character,则认为这个参数是由一对括号包裹(可以认为 { 标记参数的开始位置,} 标记结束位置,它们不会在最终的参数里出现),否则这个参数就是遇到的第一个非空格记号。
读取 delimited parameter 时,不会忽略空格,这个参数由指定的定界符来标记结束的位置(定界符必须与定义时的完全匹配),并且 {} 需要正确嵌套,并且如果结果是一对正确嵌套的组,则最外层的括号不会出现在实参中。在这两种情况中,{ 可以是任意 catcode 为 1 的字符(即 begin-group character),} 可以是任意 catcode 为 2 的字符(即 end-group character)。

macro parameter(catcode=6 的字符或被 let 为这些字符的控制序列,一般是 #) + begin-group character 可以看成是一个特殊的定界符,只能放在最末尾。在匹配时,begin-group character 必须和定义时使用的字符完全一致。
如假定 [ 和 { 的 catcode 都为 1,则 \def\foo#1#[...} 在使用时也必须是 \foo aaa[...,不能是 \foo aaa{...。

了解这些之后,答案就很清楚了。\def\foo#1#2#{...},第一个参数是 undelimited parameter,第二个参数由 { 定界,#1 是 1,#2 分别是 2 和空。

需要注意的是,TeX 在读取一个控制词(如 \a、\foo 是控制词,\; 是控制符,它们都是控制序列)会忽略它后面的空格,所以 \foo␣␣ 等于 \foo␣ 等于 \foo。如前所述,macro parameter 可以是字符,也可以是控制序列,如

\let\pp#
\def\foo#1\pp2{\pp1,#2}
\def\foo#1#2{#1,#2}

两种完全一致。
空格只比较 catcode,不比较 charcode,TeX 在读取输入文本时,所有的 catcode=10 的字符都会变成 charcode=32, catcode=10 的记号。

更详细的内容可以参考 The TeXBook 第 20 章。

l3draw 相当于 pgf 中最基本的部分。tikz 的作用是把绘图代码转换为 pgf 宏。本问题相当于是说重新实现 tikz。

pgf 的一个 node 有形状、锚点、文字,还可以被保存。这些代码是很多的。

如果只要实现文字旋转和指定到某一位置,用 l3draw 提供的几个 transform 命令即可,文字使用 box 或 coffin 皆可。要指定锚点则需要自己计算文字的尺寸,然后再根据它来计算平移变换需要设置的向量。

\documentclass{article}
\usepackage{l3draw}
\usepackage{tikz}
\begin{document}

\ExplSyntaxOn

\draw_begin:
\draw_path_moveto:n { 0cm , 0cm }
\draw_path_use_clear:n { }

\group_begin:
\draw_transform_rotate:n { 30 }
\draw_transform_shift:n { 1cm , 3cm }
\hbox_set:Nn \l_tmpa_box { A }
\draw_box_use:N \l_tmpa_box
\group_end:

\draw_end:

\ExplSyntaxOff


\tikz{
  \path (0,0);
  \node[rotate=30,inner sep=0pt,outer sep=0pt,anchor=south west] at (1,3) {A};
}

\end{document}

可以参考 pgfmanual 或者相关笔记:https://ask.latexstudio.net/ask/article/175.html ,pgf 的 node 在该笔记的第二十五章。

时间是从开始编译时到完全展开此函数时用的时间,这个整数除以 2^16 得到以秒为单位的时间。在不同的位置完全展开它,可以得到不同的值。

“CPU 时间”和“等待用户输入的时间”就是字面意思——执行此程序花费了 CPU 多少时间、等待用户输入花费了多少时间,程序在 IO 的过程 CPU 会去干别的事,IO 完成后再由操作系统把 CPU 叫回来继续执行。而且,在目前的桌面操作系统下,CPU 并不总是一直执行一个程序,而是一会执行这个程序一会执行那个。所以 CPU 时间并不是你感知到的程序执行的时间(real time)。

TeX 除了可以从文件读入,也支持从终端读入,比如

\ior_get_term:nN { Please~input:~ } \l_tmpa_tl

就会在终端中显示 Please input: ,等待用户输入,再把输入的内容保存到 \l_tmpa_tl 中。

并不是所有 x 中的 # 都需要双写。直接用 primitive 实现的一般不需要双写。但是即使这样也有例外情况,这应该是 LaTeX3 的函数命名不一致导致的,由于 \cs_new:Npx 这些函数使用广泛,目前看来不太可能再修改它们的名称了。目前我记得的不需要双写的 # 的 x 参数有 \cs_new... 和 \cs_(g)set... 系列以及 \iow_shipout_x:Nn。所有的 \exp_.. 中的 x 都需要双写(包括 \cs_generate_variant:Nn 和 \prg_generate_conditional_variant:Nnn 生成的变体)。
需要双写的原因是定义了一个临时的宏,见后文。

当 # 作为引用参数的标识时,它应该仅写一次(随嵌套次数而倍增),当 # 作为它自己时,应该双写。
需要双写的 # 可以使用 \exp_not:n 包裹起来,这样就不要双写。如可以 \use:x { \exp_not:n { \def\tmp#1{#1} } }。

\cs_new:Npx 相当于 \long\edef。这里的 x 其实是 e。

定义函数时,\edef\test#1#2{#1,#2},括号里的 #1 #2 是引用第一、二个参数,应该把它们看成一个整体作为 1 个记号,## 也应当看成一个记号。\test 实际上是:两个参数的宏,它展开为 <参数1>,<参数2>。
\edef\test#1{\def\noexpand\foo##1#1##2{##1 ##2 #1 \def\foo####1{####1##2}}},\test 是有一个参数的宏,它展开为 \def\foo#1<参数1>#2{#1 #2 <参数1> \def\foo##1{##1#2}}。

而 \use:x 实际上是 \def\use:x#1{\edef\temp{#1}\temp},当写 \use:x{?#1?} 时,\use:x 展开为 \edef\temp{?#1?}\temp,此时在定义 \temp 时就会出错,因为它没有参数,但它的替换文本中却引用了参数,所以必须双写 \use:x{?##1?},此时 ## 表示 #,而不是引用参数的标识。

而 \use:e 则不是这样,它使用 \expanded primitive 实现,没有定义一个临时的宏,# 直接就是作为它自己。

还是那句话,能使用 e 就使用 e 而非 x。

1.
你的理解是对的,定义函数时遵循这个规则可以在需要展开其参数时不至于有太大的开销。
如果需要展开 nofe 参数之后的参数,如 \foo:Nno、\foo:Nne、\foo:Nff、\foo:NnV、\foo:no,只有使用 \expanded primitive(\tex_expanded:D)才是最快的。而所谓的“optimized function”则总可以找到一个不用 \expanded 实现且比 \expanded 快的方法。(“最快”与“更快”都是从一般的情况来说的)

就是说,使用 \expanded 实现的函数都认为是需要更慢的处理。

在终端中执行 latexdef -b \ExplSyntaxOn -a \ExplSyntaxOff \exp_args:NVo 可以查看 \exp_args:NVo 的定义,(目前)它是用 \expanded 实现的,但可以找到一个不用 \expanded (且比它快)的实现:

\cs_gset:Npn \exp_args:NVo #1#2#3
  {
    \exp_after:wN #1
    \exp_after:wN { \exp:w \exp_after:wN
      \__exp_eval_register:N \exp_after:wN #2 \exp_after:wN }
    \exp_after:wN { #3 }
  }

\exp_args:NNVV 和 \exp_args:NcVV 也是如此。但由于它们目前都是使用 \expanded 实现的,因此才把它们归类到需要更慢的处理的函数上。

2.
last_unbraced 就是最后一个参数展开的结果的最外层不自动添加 {}。比如

\tl_set:Nn \foo { ab }
\exp_args:No \faa { \foo }          % 结果是 \faa { ab }
\exp_last_unbraced:No \faa { \foo } % 结果是 \faa ab

如果展开的结果中有括号,也不会移除括号。另外,N 和 c 参数的结果总是不自动添加 {}。

3.
这些是用来定义 \exp_args:... 和 \exp_last_unbraced:... 的。已经明确表示应当仅用于 l3expan 这个模块中,当然想在其它地方用也不是不可以。
\::: 作为分割符,前面的是展开方式,后面的是参数。
比如 \::n \::f \::o \::e \::e_unbraced \::: 就是 \::: 后面的那一项移除可能的括号,接着对随后的那些项依次进行指定的展开。(\.._unbraced 只能是最后一个)
好处是不受 TeX 的函数最多 9 个参数的限制,坏处是甚至可能比 \expanded 更慢。

把图片名分别保存到 seq 里即可。

\seq_new:N \g__my_chapter_oimage_seq % odd 
\seq_new:N \g__my_chapter_eimage_seq % even 
\seq_new:N \g__my_part_oimage_seq % odd 
\seq_new:N \g__my_part_eimage_seq % even 

\keys_define:nn { my/titleimage }
  {
    chapteroddimage  .code:n = 
      \seq_gset_from_clist:Nn \g__my_chapter_oimage_seq {#1} ,
    chapterevenimage .code:n = 
      \seq_gset_from_clist:Nn \g__my_chapter_eimage_seq {#1} ,
    partoddimage     .code:n = 
      \seq_gset_from_clist:Nn \g__my_part_oimage_seq    {#1} ,
    partevenimage    .code:n = 
      \seq_gset_from_clist:Nn \g__my_part_eimage_seq    {#1} ,
  }
\cs_new:Npn \__my_title_image:Nn #1#2 % image seq, number
  { \seq_item:Nn #1 { \int_mod:nn {#2} { \seq_count:N #1 } + 1 } }
\cs_new:Npn \my@chapterimagename
  {
    \int_if_odd:nTF { \value{page} } 
      { \__my_title_image:Nn \g__my_chapter_oimage_seq { \value{chapter} } }
      { \__my_title_image:Nn \g__my_chapter_eimage_seq { \value{chapter} } }
  }
\cs_new:Npn \my@partimagename
  {
    \int_if_odd:nTF { \value{page} }
      { \__my_title_image:Nn \g__my_part_oimage_seq { \value{part} } }
      { \__my_title_image:Nn \g__my_part_eimage_seq { \value{part} } }
  }
\cs_new_protected:Npn \titleimage #1 
  { \keys_set:nn { my/titleimage } {#1} }

使用时

\titleimage{
  chapteroddimage={inner_pics/songodd, inner_pics/yinghuaodd},
  chapterevenimage={inner_pics/songeven, inner_pics/yinghuaeven},
  ...
}

\includegraphics{\my@chapterimagename} % 会自动改变
\includegraphics{\my@partimagename}    % 会自动改变

放到文档类中时,不要用 my 作为模块名,改成你自己的名字。

1.
忽略类别码(catcode)是指在比较两个 token list 时,先把它们 \detokenize,然后再按字典序比较,(也就是不比较它们的类别码,因为经过 \detokenize 后,同一字符的类别码都相同,控制序列也没有了),即使用 \str_if_eq:...,反之,则使用 \tl_if_eq:...。

\str_set:Nn \a { ~ \\ $ }
\tl_set:Nn  \b { ~ \\ $ }
\tl_set:Nx  \c { \c_space_tl \c_backslash_str \c_backslash_str \c_dollar_str }

\a 和 \c 的值完全相同:即,它们的长度相同且每一对字符的 (catcode,charcode) 完全相同,也就是 \tl_if_eq:NNTF \a \c 返回 true 分支。
\b 和 \c 的长度不同,即 \tl_if_eq:NNTF \b \c 返回 false 分支。但对 \b 的值使用 \detokenize(\tl_to_str:n)之后,就变成了 \c(的值),也就是 \str_if_eq:NNTF \b \c 返回 true 分支。

prop 中 key 的比较就是使用 \str_if_eq:...。
“忽略类别码”只有在比较 token list 时才有意义。

(在 (u)pTeX 中应该是 kcatcode 而非 catcode。)

2.
\prop_set_from_keyval:Nn 是使用 \keyval_parse:nnn 实现的。
\tl_trim_spaces:n 移除首尾空格,但在此之后,如果结果是一个正确嵌套的组(如 {a } 是,{a}{b} 不是),并不会继续移除外层的 {}。而 \keyval_parse:nnn 在分别解析 key 和 value 时则会继续移除外层的 {}。

{~a~}~ = ~bc~ ,  % key 是 " a ",value 是 "bc"
~a~ = {~bc~}~ ,  % key 是 "a",value 是 " bc "
{ a= } = {b=c} , % key 是 "a=",value 是 "b=c"
{ a, } = {b,} ,  % key 是 "a,",value 是 "b,"
a =,             % key 是 "a",value 是 ""
a,               % key 是 "a",没有 value
这样,key 和 value 中可以包含空格、逗号和等号

如上例。\keyval_parse:nnn 并不会修改 key 和 value 的类别码。

3.
某些情况下可能会改变 =, 的类别码为 13(active),这样解析键值时就会出错,比如 keyval 宏包。
\keyval_parse:nnn 专门处理了这种情况。方法是递归。
先以 active , 分割出 n 项,然后对这 n 项分别以 other , 分割,由此得到 key=val。再对 = 施以类似的操作,由此得到每个 key 与 对应的 value。

发布
问题